Le SEO technique (ou référencement technique) regroupe les réglages qui permettent aux moteurs de recherche d’explorer, d’interpréter et d’indexer correctement les pages d’un site web.
Vos meilleures pages sont-elles vraiment vues par Google et lues de la bonne façon ?
Dans ce guide, vous allez découvrir :
- comment Google explore, interprète et indexe un site (et où ça bloque le plus souvent) ;
- les réglages de base : robots.txt, sitemap XML, balise canonical, redirections 301 et codes d’erreur ;
- comment la vitesse, le mobile, HTTPS, les données structurées et hreflang complètent ces bases ;
- par où commencer, liste de vérification à l’appui.
Qu’est-ce que le SEO technique ?
Le SEO technique s’occupe de l’infrastructure d’un site plutôt que de ses textes : le serveur, le code HTML, les URL, les fichiers que lisent les robots, la vitesse et l’affichage sur mobile. Son but est simple : qu’un robot d’exploration comme Googlebot atteigne chaque page utile, la lise telle qu’un visiteur la voit et la range au bon endroit dans l’index. Un texte remarquable sur une page absente de l’index a la même visibilité qu’un brouillon. Avant de retoucher un texte, il vaut donc mieux vérifier que Google voit la page, que vous travailliez seul ou avec une agence SEO à Montréal.
Comment Google explore et indexe un site
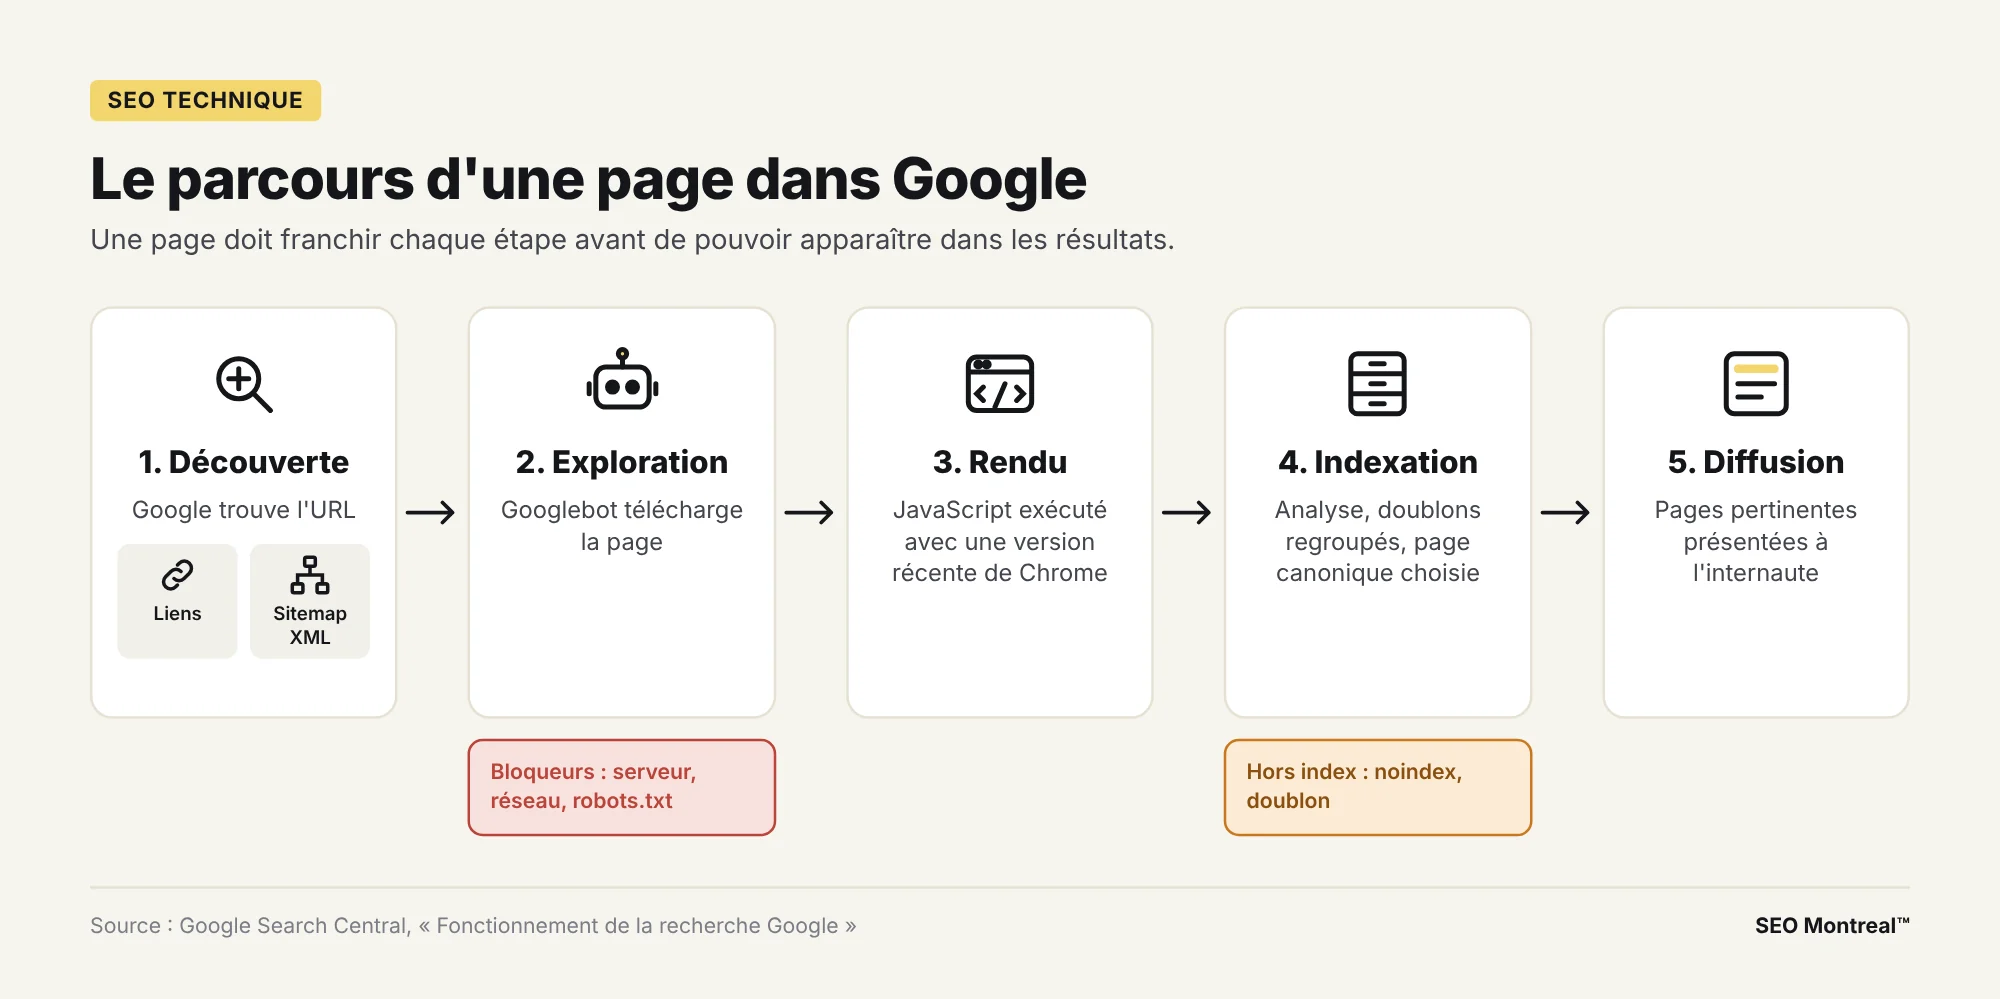
Google décrit trois étapes. À l’exploration (le crawl), Googlebot télécharge le texte, les images et les vidéos des pages qu’il découvre, surtout en suivant un lien d’une page connue vers une nouvelle page ou en lisant un sitemap. À l’indexation, Google analyse le contenu, regroupe les pages en double et retient une page canonique : c’est elle qui peut s’afficher dans les résultats de recherche. À la diffusion, quand quelqu’un cherche, les algorithmes de classement de Google présentent les pages indexées les plus pertinentes.
Entre l’exploration et l’indexation se glisse le rendu : Google affiche la page et exécute son JavaScript avec une version récente de Chrome. Un texte ou un menu qui apparaît seulement après ce script passe donc par une étape de plus. Pour les éléments importants (titres, textes, liens du menu), le plus sûr reste de les servir directement dans le HTML, sous forme de texte : Google rappelle que le format textuel est le moyen le plus fiable de l’aider à interpréter une page.
Chaque étape peut échouer. Google cite trois causes fréquentes de blocage à l’exploration : un problème de serveur, un problème de réseau ou une règle du robots.txt qui interdit l’accès à Googlebot. Une page explorée peut aussi rester hors de l’index, par exemple si elle porte une balise noindex ou si Google la considère comme un doublon d’une autre page. Quant au budget d’exploration (l’ensemble des URL que Google peut et veut explorer), Google destine son guide aux très gros sites et à ceux dont le contenu change chaque jour : un site de PME n’a généralement pas à s’en soucier.
Robots.txt et sitemap : orienter l’exploration
Trois outils orientent les robots et on les confond souvent. Le robots.txt et le sitemap agissent sur l’exploration ; la balise noindex agit sur l’index.
Le fichier robots.txt gère l’exploration
Placé à la racine du site (exemple.ca/robots.txt), le robots.txt sert d’abord à gérer le trafic des robots d’exploration. Google le dit sans détour : ce fichier règle l’exploration, pas la présence dans les résultats. Une URL bloquée peut tout de même apparaître dans Google, sans description, si d’autres pages la lient. Sur WordPress, une extension SEO comme Yoast SEO ou Rank Math permet de modifier ce fichier depuis le tableau de bord.
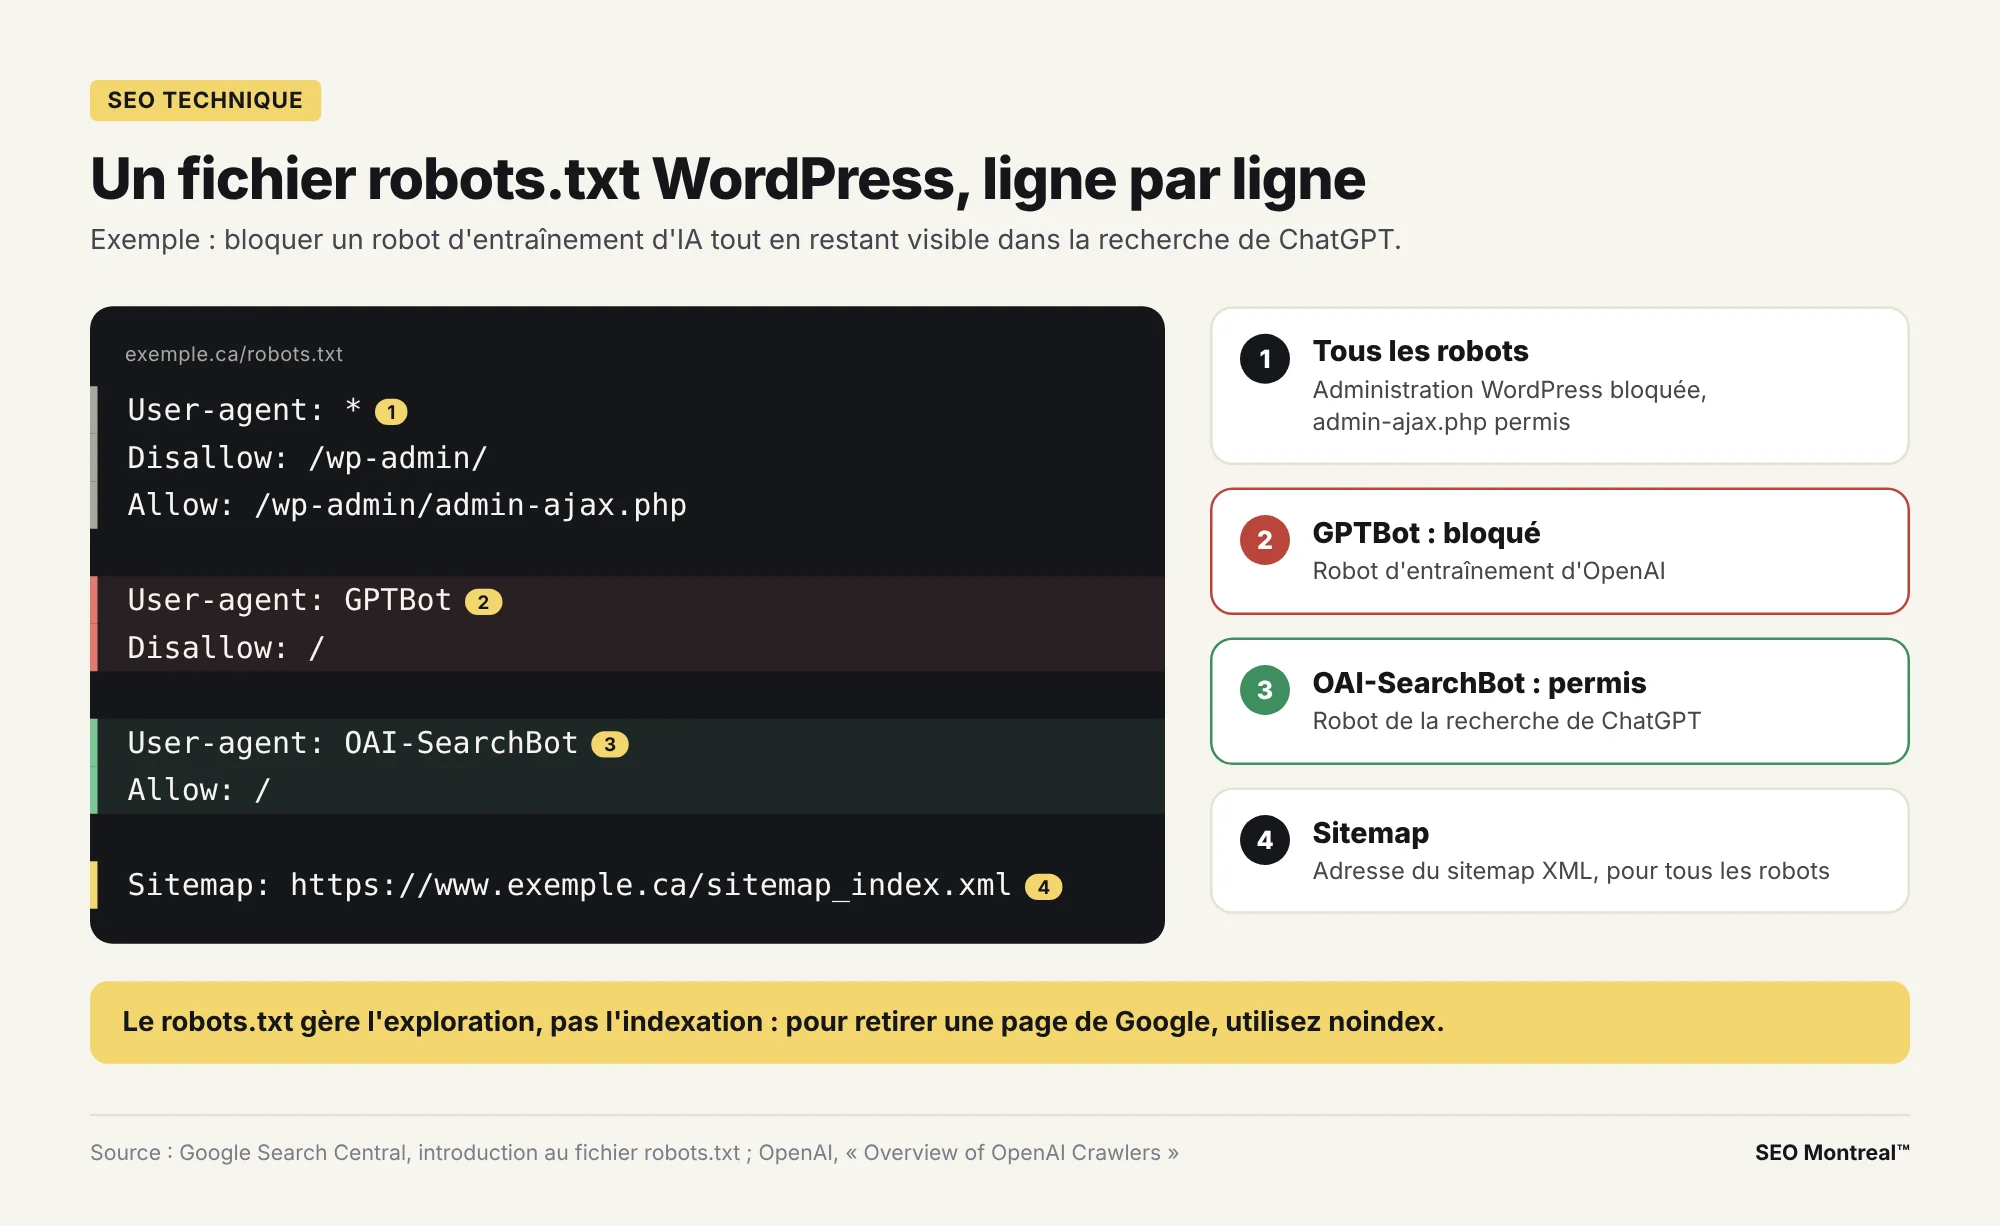
Voici un robots.txt typique d’un site WordPress qui bloque un robot d’entraînement d’IA tout en restant visible dans la recherche de ChatGPT :
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /

Sitemap: https://www.exemple.ca/sitemap_index.xml
Le premier groupe tient tous les robots hors de l’administration WordPress, sauf le fichier technique admin-ajax.php, dont certaines extensions ont besoin côté public. Le deuxième ferme le site à GPTBot. Le troisième ouvre explicitement le site à OAI-SearchBot. La dernière ligne indique l’adresse du sitemap à tous les robots.
Les robots des IA dans le robots.txt
Les assistants d’IA ont leurs propres robots, chacun avec un rôle précis selon son éditeur :
- GPTBot (OpenAI) explore du contenu qui peut servir à entraîner les modèles d’IA générative d’OpenAI ;
- OAI-SearchBot (OpenAI) sert à faire apparaître des sites dans les résultats de recherche de ChatGPT : selon OpenAI, un site qui le bloque n’apparaît pas dans ces réponses, sauf comme simple lien de navigation ;
- ClaudeBot (Anthropic) recueille du contenu qui peut servir à l’entraînement des modèles d’Anthropic, tandis que Claude-SearchBot explore le web pour améliorer les résultats de recherche offerts aux utilisateurs ;
- PerplexityBot (Perplexity) sert à faire apparaître et à lier des sites dans les résultats de Perplexity ; Perplexity précise qu’il sert à la recherche, pas à l’entraînement de modèles.
Bloquer un robot d’entraînement comme GPTBot ou ClaudeBot vise seulement ce robot : Googlebot suit ses propres règles. Les agents qui visitent une page à la demande d’un utilisateur, comme ChatGPT-User ou Perplexity-User, peuvent par contre ignorer le robots.txt, selon leurs éditeurs. Le bon réglage dépend de votre stratégie de visibilité dans les réponses des IA, le terrain d’une agence GEO.
Le sitemap XML et la balise noindex
Le sitemap XML liste les pages que vous voulez voir explorées. Google le considère comme une aide, sans garantie d’exploration ni d’indexation. Un site d’environ 500 pages ou moins, bien relié par ses liens internes, peut souvent s’en passer selon Google. Sur WordPress, les extensions SEO le génèrent automatiquement : il reste à le soumettre dans la Search Console et à en retirer les URL redirigées ou en erreur.
Pour garder une page hors de l’index (page de remerciement, résultats de recherche interne), c’est la balise noindex qu’il faut. Piège classique : si le robots.txt bloque la page, la balise noindex reste invisible pour Googlebot et l’URL peut rester dans les résultats. Autre classique après une mise en ligne : la case « Demander aux moteurs de recherche de ne pas indexer ce site », dans Réglages > Lecture de WordPress, restée cochée depuis le développement.
Redirections 301 et codes d’erreur HTTP
Chaque URL répond par un code d’état HTTP. Ceux qu’il faut connaître :
- 200 : la page répond normalement ; l’indexation reste à gagner ;
- 301 ou 308 : déplacement permanent ; Google y voit un signal fort que la nouvelle URL doit devenir canonique ;
- 302 : déplacement temporaire, à réserver aux changements qui seront annulés ;
- 404 ou 410 : la page est introuvable ; une URL déjà indexée qui renvoie une erreur 4xx est retirée de l’index ;
- 500 et autres 5xx : erreur du serveur ; Googlebot ralentit l’exploration, puis retire de l’index les URL qui renvoient l’erreur de façon continue ;
- soft 404 : une page vide ou « introuvable » qui répond pourtant 200, que la Search Console signale à part.
Googlebot suit jusqu’à 10 redirections à la suite, mais chaque saut ajoute un délai pour le visiteur. Visez une seule redirection, de l’ancienne URL directement vers la nouvelle. Corrigez aussi les chaînes de redirections qui s’accumulent au fil des refontes.
Plan de redirections pour une refonte
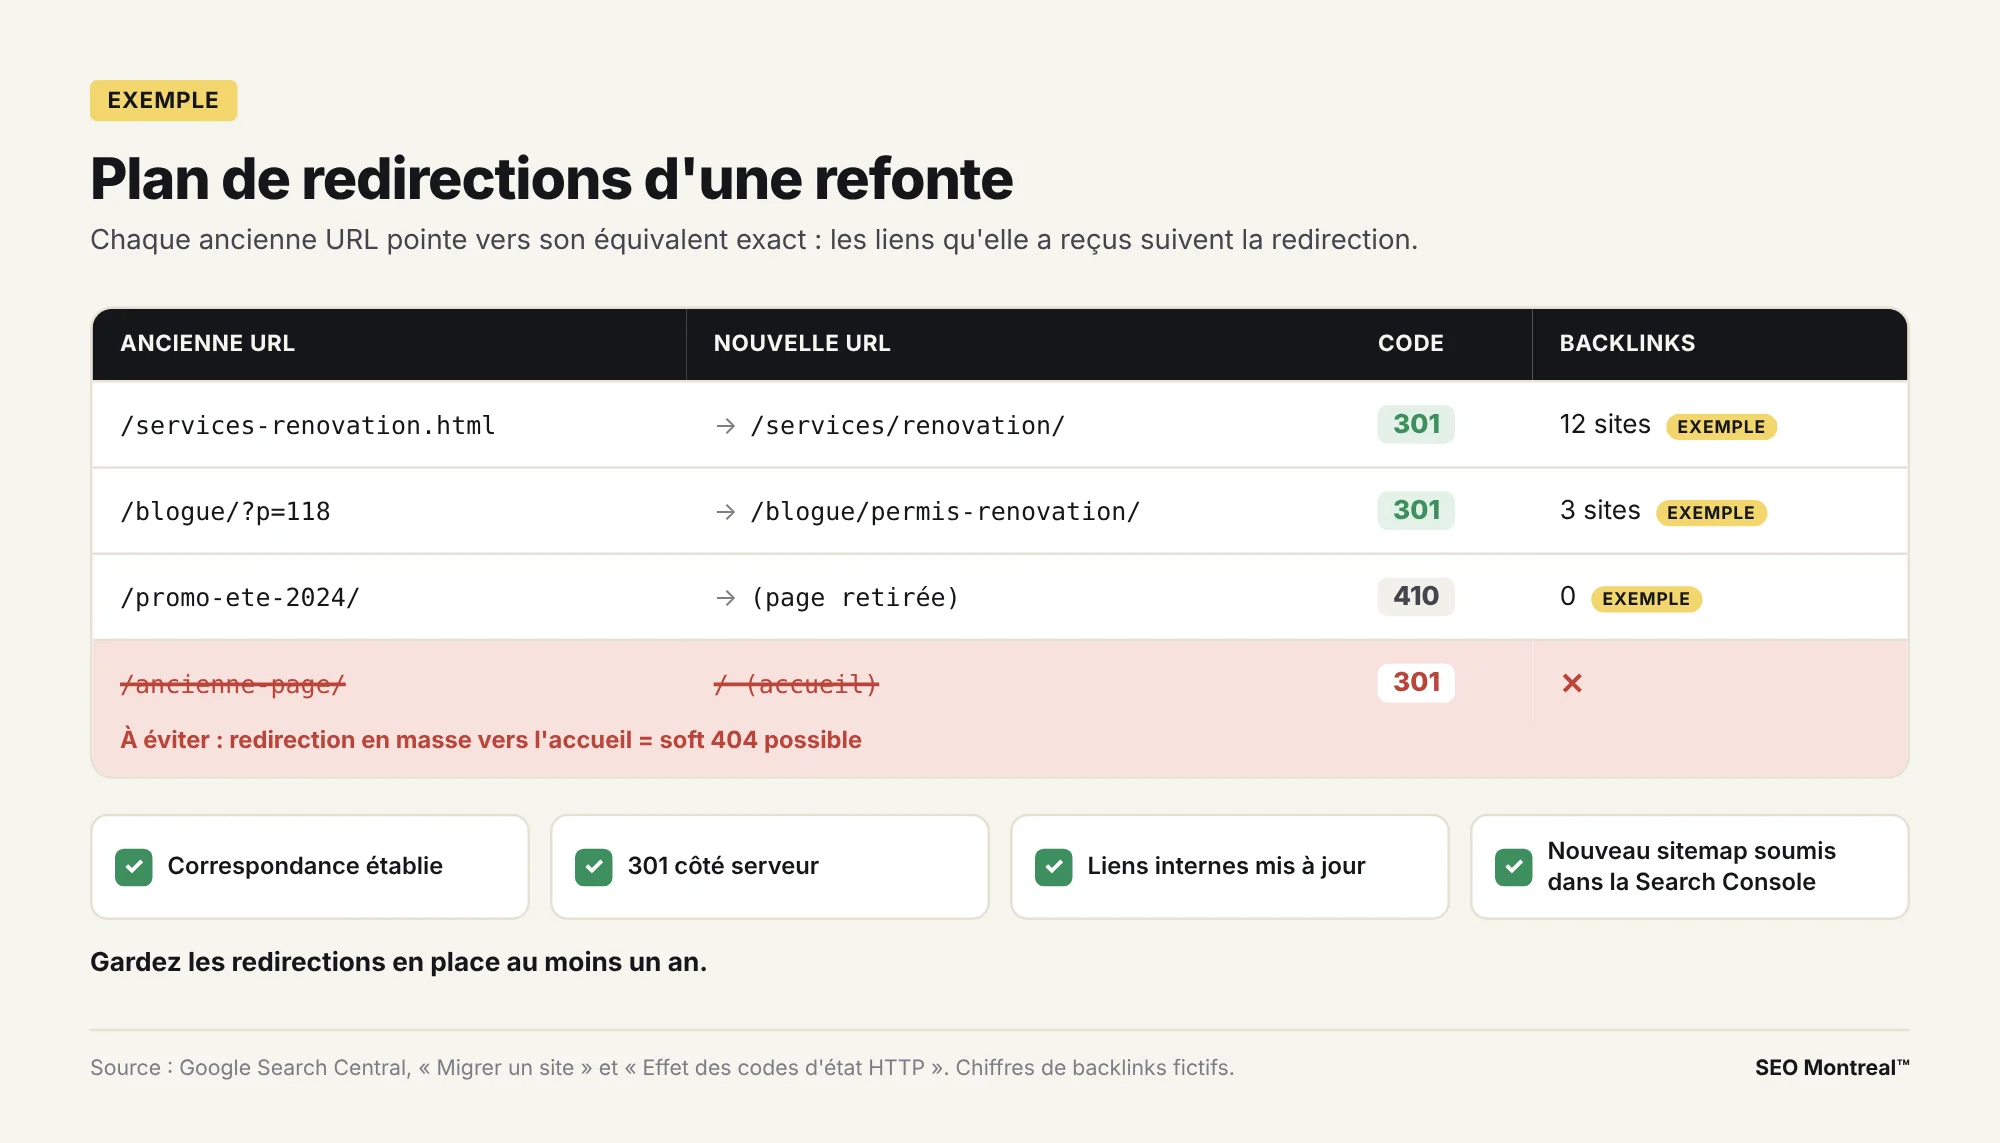
Une refonte qui change les URL met en jeu tous les liens acquis par les anciennes adresses. Google recommande d’établir la correspondance entre chaque ancienne URL et la nouvelle, de mettre en place des redirections permanentes côté serveur, de mettre à jour les liens internes puis de soumettre le nouveau sitemap dans la Search Console. Il déconseille de rediriger en masse les anciennes URL vers une même page (l’accueil, par exemple), ce qu’il peut traiter comme une soft 404. Pour vos meilleurs backlinks, Google suggère même de demander aux sites concernés de mettre leur lien à jour.
Sur un projet de conception de site web ou de refonte, ce tableau de correspondance se prépare avant la première maquette. Les pages qui reçoivent des backlinks ou du trafic organique passent en premier.
Architecture du site et maillage interne
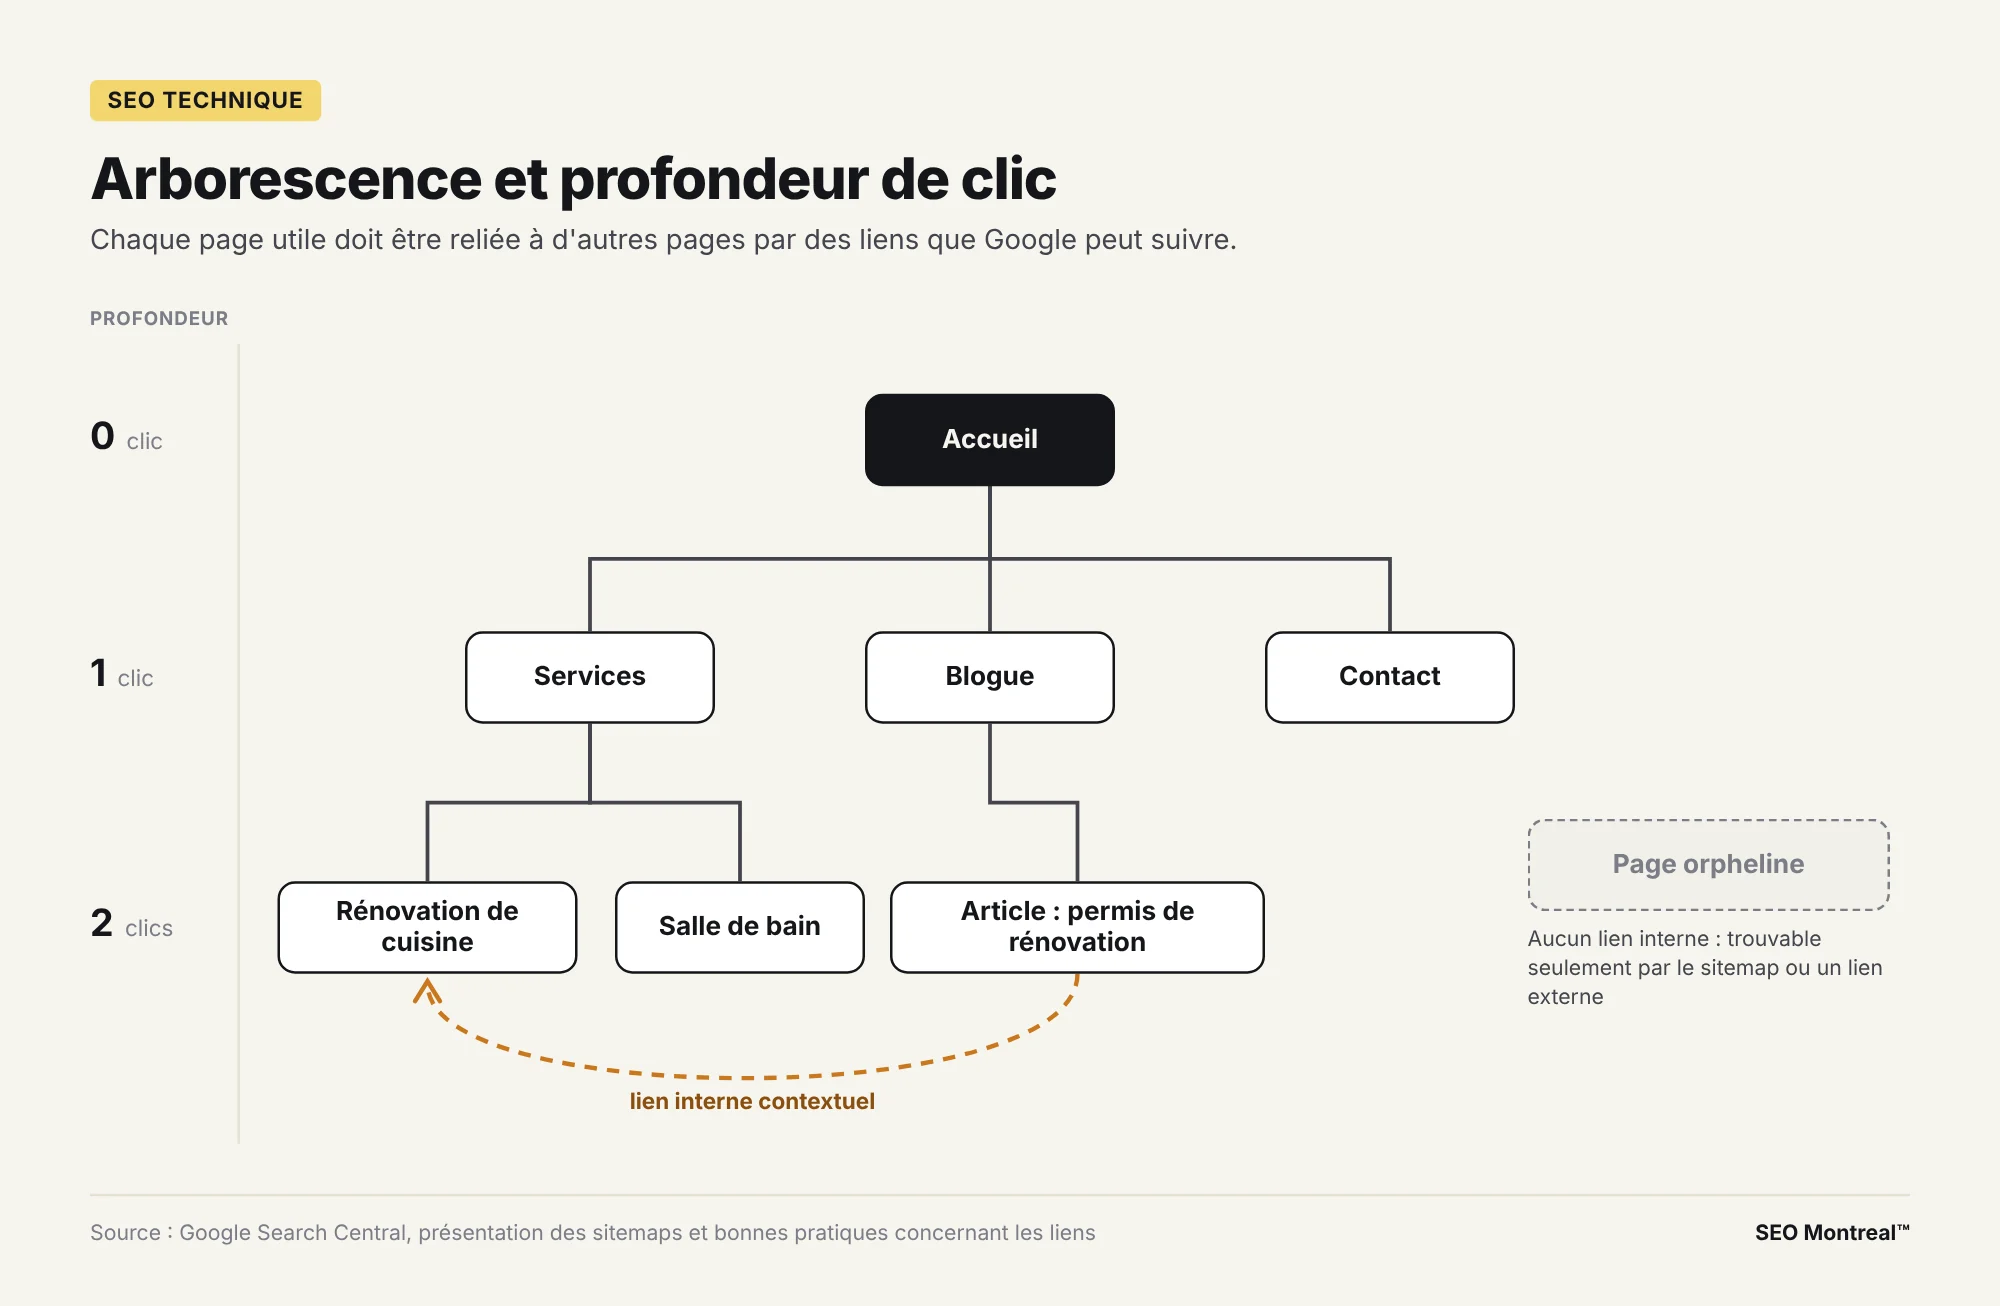
L’architecture d’un site, c’est la façon dont ses pages sont rangées et reliées. Une structure claire part de l’accueil, passe par quelques grandes catégories puis descend vers les pages de détail, avec des URL qui suivent la même logique (exemple.ca/services/renovation-cuisine/). Google indique qu’il peut trouver les pages importantes en suivant les liens depuis la page d’accueil. Son guide de démarrage SEO ajoute que regrouper des sujets similaires dans des répertoires peut l’aider à déterminer la fréquence de modification des URL de chaque répertoire.
La profondeur de clic compte le nombre de clics entre l’accueil et une page. Une page privée de tout lien interne, dite orpheline, dépend du sitemap ou de liens externes pour être découverte.
Maillage interne et texte d’ancre
Google recommande que chaque page importante reçoive un lien depuis au moins une autre page du site. Il ajoute que « le texte d’ancrage contextualise le lien et définit les attentes de vos lecteurs ». En pratique : liez vos pages de service depuis l’accueil et le menu, faites pointer chaque article de blogue vers le service qu’il explique puis choisissez une ancre qui décrit la page visée plutôt que « cliquez ici ». Les liens doivent être de vrais éléments <a href> : Google suit en général seulement les liens dans ce format.
Vitesse du site et Core Web Vitals
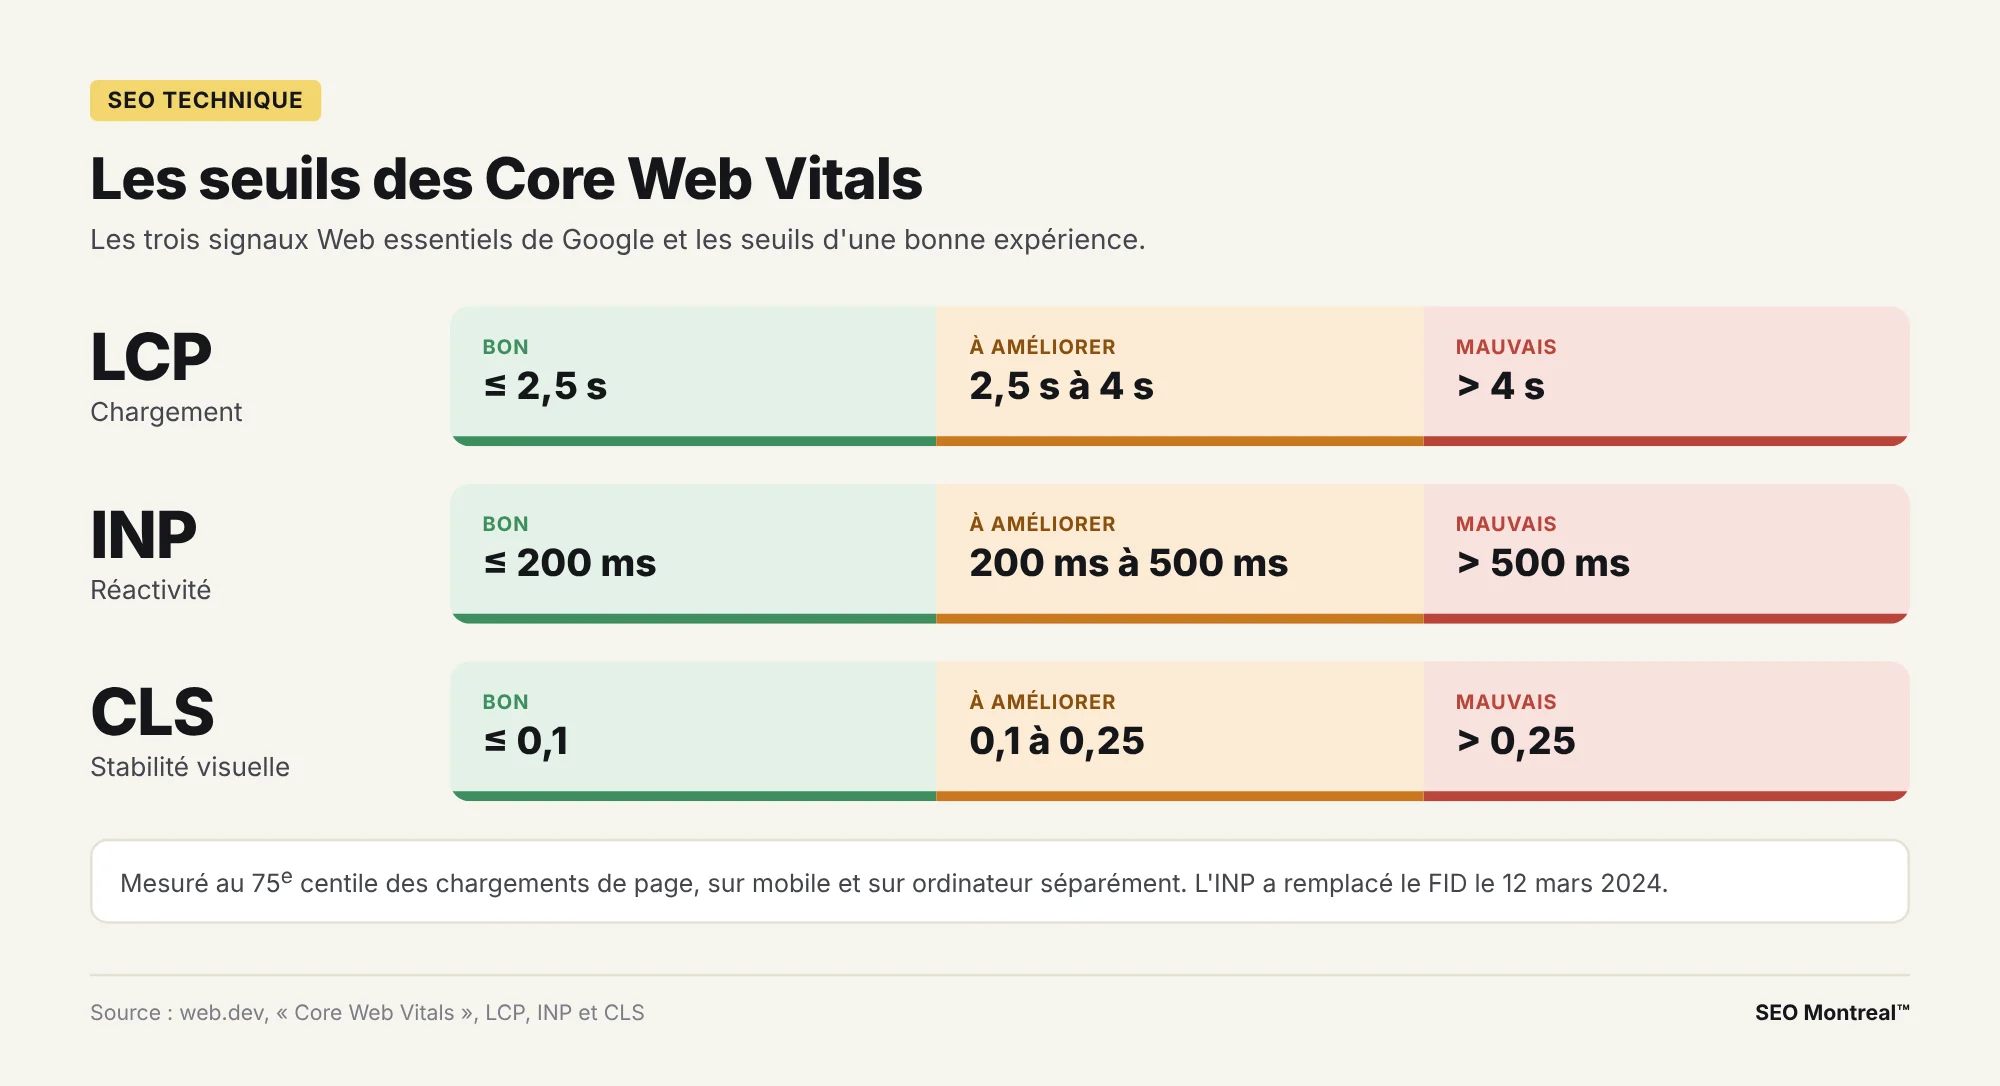
Les Core Web Vitals (signaux Web essentiels) mesurent l’expérience utilisateur réelle, dont la vitesse de chargement perçue :
- LCP (Largest Contentful Paint) mesure le chargement : le plus grand élément visible doit s’afficher en 2,5 secondes ou moins ;
- INP (Interaction to Next Paint) mesure la réactivité : 200 millisecondes ou moins entre une interaction et la réponse visible de la page ;
- CLS (Cumulative Layout Shift) mesure la stabilité visuelle : un score de 0,1 ou moins, pour que la page cesse de sauter pendant la lecture.
Le site web.dev de Google fixe la cible au 75e centile des chargements de page, sur mobile comme sur ordinateur. Au-delà de 4 secondes pour le LCP, de 500 millisecondes pour l’INP ou de 0,25 pour le CLS, la mesure est jugée mauvaise. L’INP a remplacé le FID (First Input Delay) le 12 mars 2024 : un conseil qui parle encore du FID date d’avant.
Google confirme que ses systèmes de classement utilisent les Core Web Vitals. Il précise aussi qu’un bon rapport reste sans garantie de première place : quand plusieurs pages répondent aussi bien à une recherche, une bonne expérience sur la page peut faire la différence.
Améliorer la vitesse d’un site WordPress
Sur WordPress, les gains viennent souvent des mêmes endroits : des images trop lourdes (à compresser et à servir en WebP), l’absence d’extension de cache, un hébergement lent, l’absence de réseau de diffusion de contenu (CDN), des scripts tiers et des extensions en trop. Le chargement différé (lazy loading) convient aux images situées plus bas dans la page ; évitez-le sur l’image principale du haut, qui compte souvent pour le LCP. Réservez la hauteur des images et des bannières pour limiter le CLS. Mesurez avant et après chaque changement avec PageSpeed Insights.
Mobile et HTTPS, prérequis du référencement technique
L’indexation mobile d’abord
Google utilise la version mobile du contenu d’un site, explorée avec l’agent pour smartphone, pour l’indexer et le classer : c’est l’indexation mobile d’abord (mobile-first). Le texte, les images, les liens et les données structurées doivent donc être les mêmes sur mobile et sur ordinateur. Google recommande le responsive design, une seule page qui s’adapte à l’écran. Un texte ou des liens retirés de la version mobile disparaissent pour Google.
HTTPS et sécurité du site
HTTPS chiffre les échanges entre le navigateur et le serveur avec le protocole TLS ; un certificat SSL/TLS atteste l’identité du site. Google a annoncé en août 2014 qu’il utilisait HTTPS comme signal de classement ; ses consignes le recommandent toujours. Une seule version du site doit répondre : en https, avec ou sans www selon votre choix. Chaque URL en http redirige en 301 vers sa version https ; les liens internes pointent directement vers la version finale.
Données structurées et résultats enrichis
Les données structurées sont un format normalisé qui décrit le contenu d’une page : un article, une entreprise locale, un produit, un événement. Google s’appuie sur ces données pour comprendre la page et recommande en général le format JSON-LD, basé sur le vocabulaire schema.org. Certains types rendent la page admissible à des résultats enrichis, comme le prix d’un produit ou le fil d’Ariane. Sur WordPress, les extensions SEO ajoutent déjà les types de base (Article, Organization, fil d’Ariane).
Méfiez-vous des conseils datés : le résultat enrichi de type FAQ n’apparaît plus dans la recherche Google depuis le 7 mai 2026. Le balisage reste du schema.org valide, mais il ne produit plus cet affichage. Validez vos données structurées avec le test des résultats enrichis de Google avant chaque mise en ligne.
Contenu dupliqué et URL canonique
Le contenu dupliqué technique vient rarement d’un copier-coller : il naît de plusieurs URL qui affichent la même page. Exemples : http et https, avec et sans www, paramètres de suivi (?utm_source=), filtres et tris d’une boutique en ligne, archives d’étiquettes de WordPress. Face à des doublons, Google choisit une page canonique : c’est elle qui peut s’afficher dans les résultats.
Vous pouvez orienter ce choix. Google classe les redirections et la balise rel= »canonical » parmi les signaux forts ; le sitemap, parmi les signaux faibles. Ces méthodes influencent le choix de Google sans le dicter. Regrouper les doublons sert aussi vos liens : Google combine alors les signaux, dont les liens qui pointent vers chaque variante, sur l’URL préférée. Sur une boutique, les URL de filtres et de tri sont une source fréquente de doublons, un chantier courant en SEO e-commerce.
Hreflang : le SEO technique d’un site bilingue
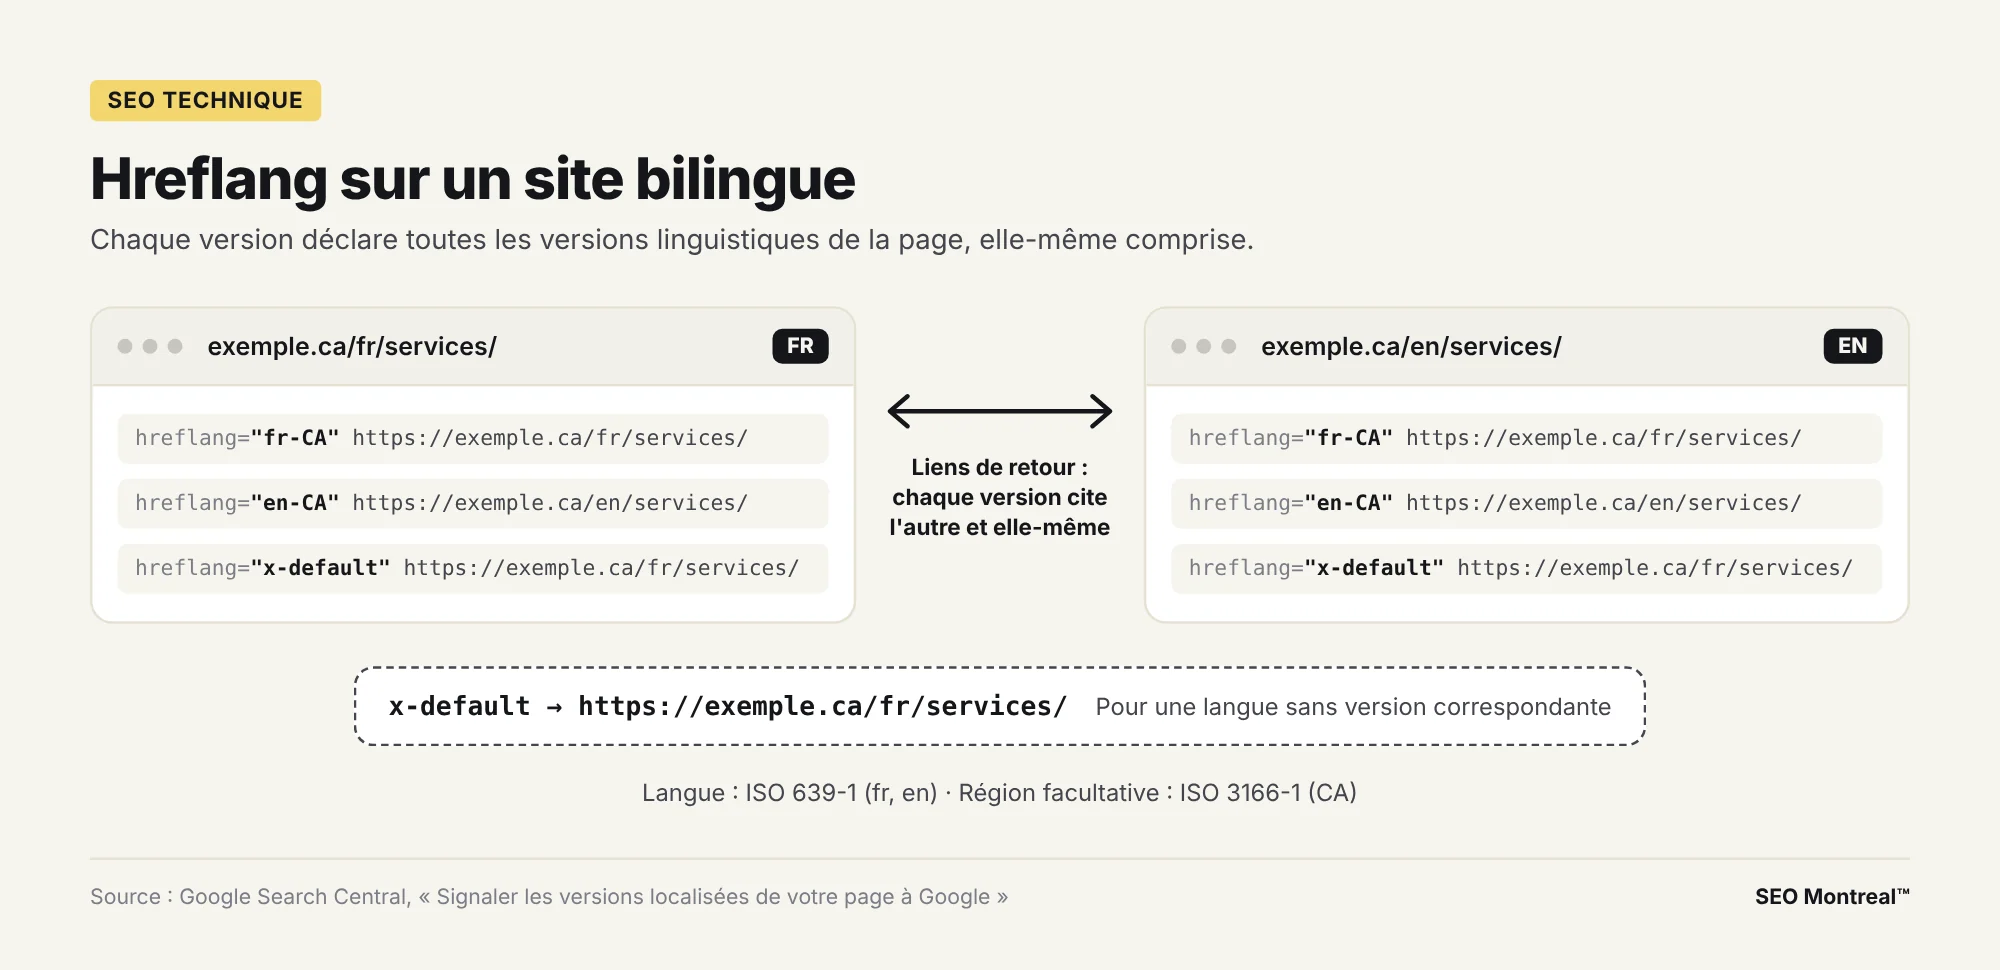
Un site offert en français et en anglais, fréquent chez les PME québécoises, doit indiquer à Google quelle version correspond à quelle langue. La balise hreflang s’en charge : chaque version se référence elle-même et liste toutes les autres. Les codes suivent la norme ISO 639-1 pour la langue (fr, en), avec un code de région ISO 3166-1 facultatif (fr-CA). La valeur x-default désigne la page à montrer pour les langues sans correspondance.
<link rel="alternate" hreflang="fr-CA" href="https://www.exemple.ca/fr/services/" />
<link rel="alternate" hreflang="en-CA" href="https://www.exemple.ca/en/services/" />
<link rel="alternate" hreflang="x-default" href="https://www.exemple.ca/fr/services/" />
Ces trois lignes vont dans la section <head> de la page française et de la page anglaise, à l’identique. Google accepte aussi un en-tête HTTP ou le sitemap XML. Sur WordPress, les extensions de traduction comme WPML ou Polylang les génèrent. Point souvent mal compris : Google détecte la langue d’une page par lui-même ; hreflang sert à relier les versions entre elles.
Quels outils pour diagnostiquer le SEO technique ?
- Google Search Console : le rapport « Indexation des pages » montre quelles pages sont indexées et la raison des exclusions ; l’outil d’inspection d’URL montre comment Google voit une page précise ; le rapport « Signaux Web essentiels » regroupe les Core Web Vitals des vrais visiteurs.
- PageSpeed Insights : les Core Web Vitals d’une URL, avec données réelles et test de laboratoire.
- Lighthouse, dans Chrome DevTools : un audit de performance directement dans votre navigateur.
- Le test des résultats enrichis de Google : valide les données structurées d’une page.
- Un robot d’exploration comme Screaming Frog : parcourt le site comme Googlebot pour repérer les erreurs 404, les liens brisés, les chaînes de redirections, les pages orphelines et les balises canonical.
- Bing Webmaster Tools : l’équivalent de la Search Console pour Bing.
- L’opérateur site: dans Google (site:exemple.ca) : un coup d’œil rapide sur l’indexation, à confirmer dans la Search Console.
Pour voir les problèmes que ces outils font ressortir le plus souvent, l’article sur les erreurs SEO courantes à corriger en priorité les regroupe par famille et fixe un ordre de correction.
Liste de vérification : audit SEO technique
Pour un site de PME, l’audit technique de base tient en treize optimisations techniques à vérifier :
- une seule version du site répond (https, avec ou sans www) ; les autres redirigent en 301 ;
- le robots.txt bloque seulement ce qui doit l’être et indique l’URL du sitemap ;
- le sitemap XML contient uniquement des URL canoniques qui répondent 200 ;
- les pages importantes figurent dans le rapport « Indexation des pages » ; les pages exclues le sont volontairement ;
- la case de visibilité de WordPress, dans Réglages > Lecture, est décochée ;
- chaque ancienne URL qui a des backlinks redirige en 301 vers la page équivalente ;
- les redirections mènent directement à la destination, sans chaîne ;
- chaque page utile reçoit des liens internes avec une ancre descriptive ;
- les Core Web Vitals sont « bons » au 75e centile, sur mobile d’abord ;
- la version mobile affiche le même contenu que la version ordinateur ;
- les données structurées passent le test des résultats enrichis ;
- chaque page française et anglaise déclare ses versions hreflang, x-default compris ;
- la Search Console et Bing Webmaster Tools sont configurés, avec alertes par courriel.
Par où commencer votre SEO technique ?
Commencez par la Search Console : le rapport d’indexation dit tout de suite si vos pages importantes sont dans l’index de Google. Corrigez d’abord ce qui empêche l’exploration ou l’indexation, puis les redirections et les liens perdus, puis la vitesse et l’affichage mobile. Le SEO technique prépare le terrain pour tout le reste du site. Si vous préférez confier ce travail, SEO Montreal™ réalise audits et corrections techniques, en projet ponctuel ou dans un mandat SEO, directement sur votre site.
Faites vérifier votre référencement technique
Réservez 30 minutes avec l’équipe : on regarde ensemble ce qui freine l’indexation de votre site.
FAQ : SEO technique
Quelle est la différence entre SEO technique et SEO on-page ?
Le SEO technique touche l’infrastructure du site : exploration, indexation, redirections, vitesse, mobile, HTTPS et code. Le SEO on-page travaille le contenu de chaque page : la balise title, la meta description, les titres, le texte et les liens internes. Les deux se croisent souvent. Une balise title mal écrite relève de l’on-page ; des centaines de titres identiques générés par un gabarit relèvent du technique.
Le SEO technique suffit-il pour se classer dans Google ?
Non. Il rend vos pages accessibles et lisibles, mais le référencement naturel dépend aussi de la pertinence du contenu et du SEO off-page, c’est-à-dire des liens que reçoit le site. Google décrit les liens comme un signal de pertinence et PageRank comme l’un de ses principaux systèmes de classement. Un site techniquement impeccable, sans contenu utile ni backlinks, reste peu visible. La technique pose la base ; le contenu et les liens bâtissent dessus.
À quelle fréquence faire un audit SEO technique ?
Faites un audit complet avant et après toute refonte, migration, changement de thème ou ajout d’une extension majeure sur WordPress. Entre les deux, surveillez les alertes de la Search Console et le rapport d’indexation des pages pour attraper les erreurs 404, les pages exclues et les baisses de Core Web Vitals. Un site qui publie souvent ou une boutique en ligne avec beaucoup de produits demande un suivi plus serré.
Faut-il bloquer GPTBot dans le fichier robots.txt ?
C’est un choix d’affaires. Selon OpenAI, GPTBot explore du contenu qui peut servir à entraîner ses modèles ; le bloquer signale que votre contenu doit rester hors de cet entraînement. OAI-SearchBot est un robot distinct qui sert à afficher des sites dans la recherche de ChatGPT : un site qui le bloque n’apparaît plus dans ces réponses, sauf comme simple lien de navigation. On peut donc bloquer l’un et permettre l’autre, ligne par ligne dans le robots.txt.
Un sitemap XML est-il obligatoire ?
Il est facultatif, mais utile sur la plupart des sites. Google indique qu’un site d’environ 500 pages ou moins, bien relié par ses liens internes, peut souvent s’en passer. Le sitemap aide surtout les gros sites, les sites neufs qui ont peu de backlinks et ceux qui publient souvent. C’est une aide sans garantie : il signale les pages, puis Google décide de les explorer et de les indexer.
Les Core Web Vitals influencent-ils le classement Google ?
Oui : Google confirme que ses systèmes de classement les utilisent. Leur poids reste à relativiser, puisqu’un bon rapport Core Web Vitals reste sans garantie d’une place en tête des résultats et que le contenu le plus pertinent peut se classer avec une expérience moyenne. Les seuils à viser au 75e centile : LCP de 2,5 secondes ou moins, INP de 200 millisecondes ou moins et CLS de 0,1 ou moins.
Comment faire du SEO technique sur WordPress ?
WordPress couvre déjà une bonne partie des bases. Une extension SEO comme Yoast SEO ou Rank Math gère le sitemap XML, le robots.txt, les balises canonical et les données structurées de base. Vérifiez ensuite la case de visibilité dans Réglages > Lecture, la structure des permaliens, une extension de cache, la compression des images et la gestion des redirections à chaque URL modifiée.
Les données structurées FAQ servent-elles encore ?
Pour Google, le résultat enrichi de type FAQ n’apparaît plus dans la recherche depuis le 7 mai 2026 ; Google a ensuite retiré sa documentation sur cette fonctionnalité en juin 2026. Le balisage FAQPage reste du schema.org valide et décrit la page aux outils qui le lisent, mais il ne produit plus d’affichage spécial dans Google. Les autres types, comme Article, Organization ou le fil d’Ariane, restent utiles.
Découvrez vos opportunités en SEO technique
Profitez d’une première analyse 100 % gratuite de votre site.